关于 WebScraping.AI
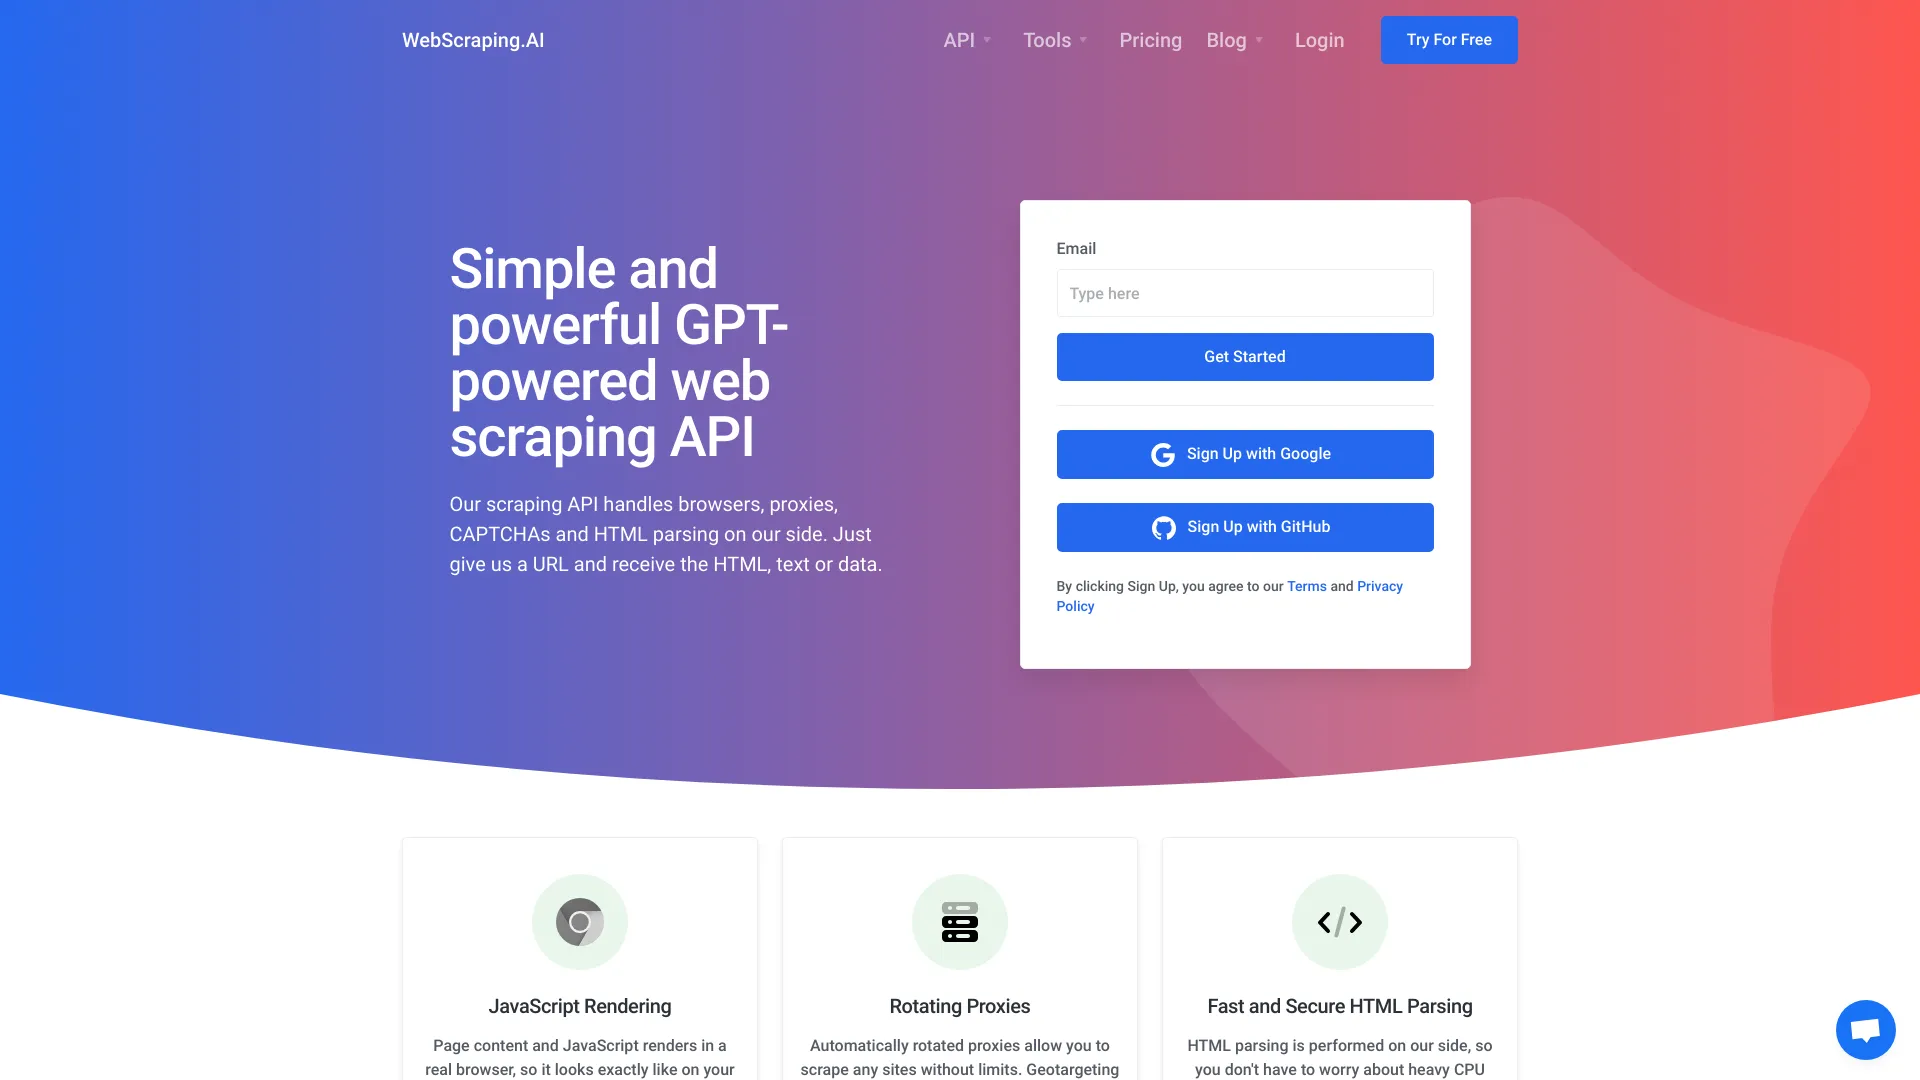
了解Webscrapping.AI和我们的任务,使开发商和企业能够进入可靠、可扩展的网络数据提取。 处理代理、无头浏览器和反机器人挑战的网络剪切API——这样你就可以专注于数据。 我们处理一个单一的API背后的网上刮网的硬部分——旋转代理人、无头浏览器的翻版和反机器人的挑战。 开发者获得干净的 HTML、文本或 AI 提取的数据, 而不建立和维护剪贴基础设施 。 我们从2016年起就致力于网络剪切 并于2019年启动了网络剪切系统 从那时起,我们一直关注一件事: 保持数据提取的可靠性, 因为网站越来越难刮。
功能特点
JavaScript 种子: 为 JavaScript-heavy 网站和 SPA 创建完整的铬浏览器 。
旋转代理人:数据中心和住宅代理人,具有自动旋转和重试逻辑。
CAPTCHA处理: 隐形代理人会遇到像云花那样的反机器人挑战,
地理目标:在13个国家与代理人接触地理限制内容,或自行代理。
回答问题:询问页面内容,并获得 AI 生成的答案 。
实地采掘:提取特定领域,作为结构合理的JSON,并附有自然语言指示。
内容摘要:获取AI生成的任何网页内容摘要。
LLM-Ready 输出:为LLM提示和RAG管道优化了清洁文本提取。